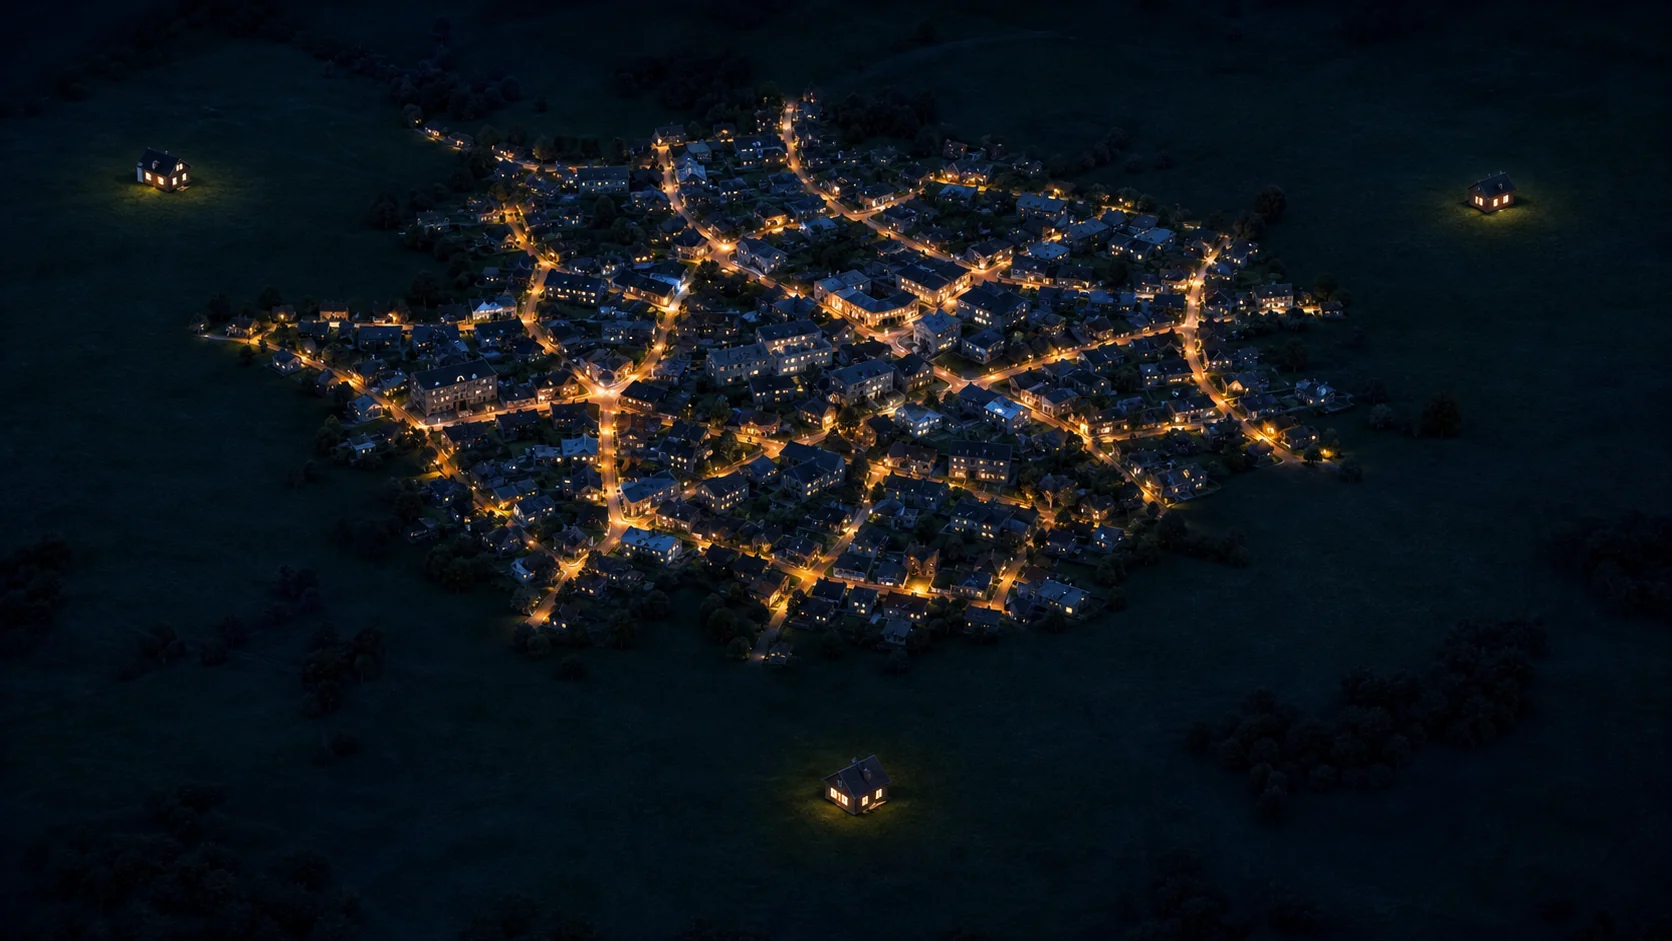
CMS'de kayıtlı, yayında, URL'si geçerli. Ama Google bu sayfayı hiç görmemiş ya da aylardır görmemiş. Sayfanın teknik olarak var olması yeterli değildir; Googlebot'un bu sayfaya ulaşacak bir yol bulması gerekir. İç link yoksa bu yol çoğunlukla yoktur.
Orphan page bu durumu tanımlar: sitede fiziksel olarak var olan ama başka hiçbir sayfadan iç link almayan URL. Googlebot sayfaları web'deki linklerden ilerleyerek keşfeder; iç linkler bu ilerlemenin haritasıdır. Haritada yer almayan sayfa düzenli tarama döngüsüne giremez. Sitemap bir listededir, ama Googlebot sitemaptaki her URL'yi periyodik olarak taramaz; özellikle crawl budget kısıtlı sitelerde bu güvence daha da zayıflar.
Bu sorunun sinsi tarafı başka hata türlerinden farklı çalışmasıdır. Sayfa 404 vermiyor, yönlendirme bozuk değil, içerik eksik değil. Tarama raporu "hata" olarak işaretlemez çünkü görmediği bir şeyi raporlayamaz. Sadece iç link almaz; bu yokluk zamanla indeksleme güçlüğüne, ardından sıralama zayıflığına dönüşür. Tespit için ayrı bir karşılaştırma adımı kurmak bu yüzden zorunludur.
İç link grafiğinde yer almayan sayfa, Googlebot için de erişilmez kalır
Googlebot sayfaları keşfetmek için birkaç yolu birlikte kullanır: daha önce taradığı sayfalardaki linkler, sitemap dosyası ve harici sitelerden gelen bağlantılar. Bu üçü içinde en güvenilir ve en sürekli çalışan yol iç linklerdir. Diğer iki kaynağa erişim her zaman garanti değildir; harici link olmayabilir, sitemap periyodik taramaya girmiyor olabilir.
Siteyi bir yönlü graf olarak düşündüğünüzde her sayfa bir düğümdür, her iç link bir kenardır. Başka hiçbin düğümün göstermediği düğüm, grafta izoledir, oraya ulaşmanın kenarı yoktur. Googlebot bu grafte kenarları izleyerek ilerler. İzole düğüme ulaşan kenar yoksa Googlebot da oraya ulaşamaz.
Bu nedenle orphan page sorunu bir içerik sorunu değil, erişilebilirlik sorunudur. İçerik kaliteli, anahtar kelime seçimi doğru, sayfa teknik açıdan sağlam olabilir. Ama içeriğin değeri ancak sayfa bulunabiliyorsa anlamlı olur. İç link yapısı analizi yapılırken orphan tespiti bu analizin doğal bir çıktısı olarak kurgulanmalıdır; iki ayrı çalışma değil, aynı sürecin iki yüzüdür.
Orphan sayfalar indekste yer alsa da sıralama gücü biriktiremez
Bir orphan sayfa geçmişte backlink almış ya da daha önce taranmış olabilir; bu durumda Google'ın indeksinde hâlâ bulunabilir. Ama bu varlık, sıralama gücü anlamına gelmez.
PageRank ve buna benzer link sinyalleri bir sayfaya hem iç hem dış linklerden akar. İç linkler siteyi tarama açısından olduğu kadar otorite dağılımı açısından da etkiler. Ana sayfadan, güçlü kategori sayfalarından ve sık taranıp güncellenen içeriklerden gelen iç linkler, bu sinyal akışının taşıyıcısıdır. Hiçbir aktif sayfaya bağlı olmayan URL bu akıştan yararlanamaz.
Etki zamanla birikir. Site büyüdükçe, menüler değiştikçe, eski içerikler güncellendikçe bazı URL'ler iç link bağlantısını sessizce kaybeder. O an fark edilmez; sayfa 404 vermediği için hiçbir alarm tetiklenmez. Sadece taranma sıklığı azalır, sinyaller birikmez, sıralama yavaş yavaş geriler. Organik trafiğin açıklanamayan düşüşlerinin bir kısmı bu sessiz kopuşlardan kaynaklanır ve kaynağı iç link grafiği incelenene kadar görünmez kalır.
Tespit hangi URL'lerin erişilemez olduğunu değil, neden erişilemez olduğunu açıklamalıdır
Orphan tespitinin temeli bir URL listesi ile tarama çıktısını karşılaştırmaktır. İki soru sorulur: sitede hangi URL'ler vardır, hangilerine tarama sırasında iç link üzerinden ulaşılabilmiştir. Bu iki listenin farkı orphan adaylarını verir.
URL listesi için kaynak birkaç seçenekten biri olabilir: sitemap.xml, CMS veya veritabanı export'u, Google Search Console'daki "Kapsam" raporu ya da önceki bir kapsamlı taramanın çıktısı. Tarama çıktısı ise Screaming Frog ya da Sitebulb gibi bir araçla yalnızca ana sayfa başlangıç noktası alınarak yapılan taramadır; bu tarama yalnızca iç linklerden ilerler. Ulaşamadığı URL'ler çıktıda görünmez.
Bu iki listenin farkı (URL listesinde olup tarama çıktısında olmayan URL'ler) potansiyel orphan'lardır. Ama her fark gerçek bir orphan değildir. Bazı URL'ler JavaScript ile render edilen linklerden bağlı olabilir; araç bunları görememiş olabilir. Bazıları noindex taşıyor olabilir, bu orphan değil, kasıtlı dışarıda bırakmadır. Bazıları ise disallow kuralıyla taramadan çıkarılmış olabilir. Fark listesindeki her URL neden erişilmediği sorusuyla ayrı ayrı değerlendirilmelidir.
Log analizi bu noktada ek bir katman sağlar. Googlebot'un hangi URL'lere gerçekte uğradığını log kayıtlarından görmek, tarama aracının göremediği bağlantıları tamamlar. Tarama aracı iç linklerden erişilemeyen ama log'da Googlebot ziyareti görünen bir URL varsa, o sayfa gerçek orphan değildir, sitemap'ten ya da harici bir linkten ulaşılmıştır. Log ve tarama verisi birlikte okunduğunda aday listesi daha doğru hale gelir ve yanlış önceliklendirme riski azalır.
Hangi sayfa türleri orphan olmaya en yatkındır
Tüm sayfalar eşit orphan riski taşımaz. Belirli koşullarda oluşturulan ya da değiştirilen sayfalar bu riski çok daha yoğun taşır.
Yeni eklenen sayfalar, özellikle içerik planıyla değil operasyonel nedenlerle oluşturulanlar, sıkça orphan olarak başlar. Bir kampanya açılış sayfası, hızla yayına alınan bir ürün URL'si, test amacıyla oluşturulan bir alt sayfa: bunlar CMS'de yaşayan ama henüz hiçbir iç sayfaya eklenmemiş olabilir. Teknik durum sorunsuzdur; link eksikliği fark edilmeden haftalar geçer.
Site migrasyonları sonrası ise orphan'lar sistemik biçimde ortaya çıkar. Eski yapının bazı URL'leri yeni yapıya tam taşınmamış, ya da taşınmış ama iç linkler güncellenmemiş olabilir. Yeni menü, yeni kategori hiyerarşisi, yeni breadcrumb sistemi: bunlar eski URL'lerin bir kısmını grafikten dışarıya iter. Migrasyon sonrası teknik denetimde orphan tespiti bu nedenle standart bir kontrol noktası olmalıdır.
Derin site yapılarında da risk yüksektir. Üç-dört seviye aşağıdaki sayfalar zaten sınırlı iç link alır; navigasyon yeniden düzenlendiğinde ya da üst kategori kaldırıldığında bağlantısız kalabilirler. Bu sayfalar sitemapte var olmaya devam eder ama hiçbir aktif sayfadan link almaz. Sayfalandırma artıkları da benzer bir yol izler: içerik güncellenince eski pagination URL'leri boşlukta kalabilir, ne canonical ile işaret edilmiş ne de iç linkten erişilebilir hale getirilmiştir.
Tarama çıktısı ile iç link verisi karşılaştırılmadan orphan listesi tamamlanamaz
Yalnızca tarama yaparak orphan tespit etmek yüzeysel bir sonuç verir. Tarama aracı iç linklerden ilerleyemediği URL'leri listeleyemez, görmediği için. Bu nedenle orphan tespiti reaktif değil, proaktif bir karşılaştırma mantığı gerektirir.
Screaming Frog'un "İç link almayan sayfalar" raporu, tarama sırasında hiçbir iç URL'den gelen link saptanmayan sayfaları listeler. Bu liste iyi bir başlangıç noktasıdır. Ama güvenilirliği taramanın kapsamlılığına bağlıdır: tarama yüzeysel kaldıysa veya bot davranışını taklit etmiyorsa, derin sayfalar zaten görülmemiştir. Raporda gösterilen "iç link almayan" sayfa gerçekten orphan mı, yoksa tarama oraya hiç ulaşamadı mı sorusu yanıtsız kalır.
Ahrefs Site Audit veya Semrush gibi araçların orphan page raporları, tipik olarak tarama çıktısını bilinen URL listesiyle harmanlayarak çalışır. Bu yaklaşım tek araçlı taramaya göre daha kapsayıcıdır. Bununla birlikte bu araçların yanlış negatif ürettiği durumlar mevcuttur: yalnızca harici backlink üzerinden bilinen URL'ler listeye dahil olmayabilir ya da JavaScript ile üretilen iç linkler tespit edilemeyebilir. Hiçbir araç raporunu tek başına kesin kabul etmek güvenli değildir.
Crawl budget kısıtlı sitelerde bu sorun daha da belirginleşir. Tarama aracı da Googlebot gibi derine inemez; her ikisi de düşük öncelikli sayfaları atlayabilir. Bu koşulda orphan tespiti araç raporuna değil, iki veri kaynağının fark analizine dayanmalıdır: sitemap veya CMS listesi ile araç tarama çıktısı. Bu farkı CSV'de birleştirip eşleşmeyen satırları ayıklamak, binlerce URL'lik sitelerde bile işlenebilir bir metodoloji sunar.
Log verisi orphan tespitini nerede tamamlar, nerede yetersiz kalır
Sunucu log analizi, orphan tespitinin en güçlü ama en az kullanılan katmanıdır. Log dosyaları Googlebot'un hangi URL'lere gerçekte ve ne zaman uğradığını gösterir; bu veri iç link analizinden veya tarama araçlarından bağımsızdır.
Googlebot'un log'da hiç görünmediği URL'ler iki farklı kategoriye düşer. İlki gerçek orphan'lardır: ne iç linkten ne sitemap'ten ne harici linkten ulaşılabilen, Googlebot'un hiç gitmediği sayfalar. İkincisi ise Googlebot'un bir ara uğramış ama düzenli tarama döngüsüne girmemiş sayfalar; bunlar belki aylardır taranmamıştır. Bu iki kategori farklı müdahale gerektirir. Birincisi için iç link eklemek yeterlidir; ikincisi önceliklendirme ya da crawl yönetimi sorununa işaret edebilir. Log olmadan bu ayrımı yapmak güçtür.
Taranabilirlik ve indeksleme sorunlarını araştırırken log verisiyle doğrulanmamış orphan listeleri yanlış öncelik kararlarına yol açabilir. Tarama aracının göremediği ama Googlebot'un sitemaptan ya da harici bir linkten ziyaret ettiği URL araç raporu açısından orphan görünür; aslında değildir. Bu yanlış pozitif, kaynakların gereksiz yere o sayfaya yönlendirilmesine neden olur.
Log erişimi her sitede mümkün değildir: CDN'ler log görünürlüğünü kısıtlayabilir, hosting planı arşivi sınırlayabilir. Bu durumda GSC'nin URL Denetleme aracı belirli URL'ler için son tarama tarihini gösterir. Toplu değil, URL bazında bir veri; ama hangi sayfanın aylardır taranmadığını tespit etmek için kullanılabilir. Öncelik listesinin üstündeki orphan adaylarını bu yöntemle manuel doğrulamak, log olmadan da anlamlı bir başlangıç sağlar.
Orphan page'leri fark edilmez kılan şey, başka sorunların aksine herhangi bir uyarı tetiklememesidir. Sayfa çalışıyor, içerik yerli yerinde, rapor temiz. Sorun yalnızca karşılaştırma yapıldığında yüzeye çıkar: sitede bilinen URL'ler ile tarama araçlarının iç linklerden ulaşabildikleri. Bu fark görülüp neden oluştuğu anlaşıldığında, müdahale çoğu durumda görece basittir. Bir ya da birkaç anlamlı iç link eklemek, sayfayı tarama grafiğine yeniden dahil eder.
Ama hangi sayfadan, hangi anchor metniyle link verileceği sorusu da dikkat ister. Rastgele seçilmiş bir iç link yerine, konu ilişkisi güçlü ve düzenli taranıp güncellenen bir kaynaktan gelen link çok daha hızlı sonuç üretir. Düzenli SEO denetiminin orphan page kontrolünü içermesi, özellikle içerik üretiminin ve site yapısının sürekli değiştiği sitelerde bu birikimi erken dönemde yakalamak açısından kritik önem taşır.